Stan książek
Nasze książki są dokładnie sprawdzone i jasno określamy stan każdej z nich.

Nowa
Książka nowa.
Używany - jak nowa
Niezauważalne lub prawie niezauważalne ślady używania. Książkę ciężko odróżnić od nowej pozycji.
Używany - dobry
Normalne ślady używania wynikające z kartkowania podczas czytania, brak większych uszkodzeń lub zagięć.
Używany - widoczne ślady użytkowania
zagięte rogi, przyniszczona okładka, książka posiada wszystkie strony.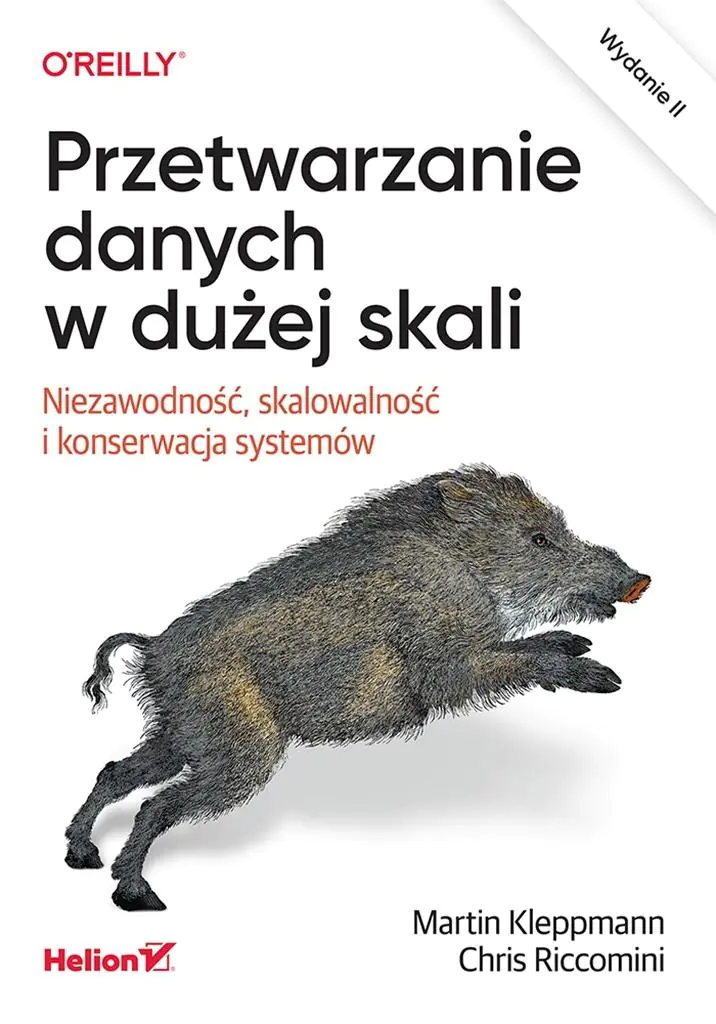
Przetwarzanie danych w dużej skali. Niezawodność, skalowalność i konserwacja systemów. Wydanie II
Masz tę lub inne książki?
Sprzedaj je u nas

W dzisiejszych czasach, gdy chmura obliczeniowa, mikroserwisy i ogromne ilości danych odgrywają kluczową rolę, każda nowoczesna aplikacja musi sprostać wyzwaniom związanym z jej skalowalnością, niezawodnością i wydajnością. Drugie wydanie kultowej książki autorstwa Martina Kleppmanna, uzupełnione o wkład Chrisa Riccominiego, stanowi szczegółowy przewodnik po architekturze systemów danych. Opisuje on zarówno relacyjne bazy danych, jak i rozproszone systemy NoSQL, a także chmurowe hurtownie danych i technologie przetwarzania strumieniowego. W aktualizacji książki uwzględniono najnowsze trendy, takie jak natywna architektura chmurowa, indeksy wektorowe w kontekście sztucznej inteligencji, jak również silniki synchronizacji i oprogramowanie local-first. Publikacja ta przeprowadza czytelników przez cały złożony ekosystem systemów danych, zaczynając od modeli przechowywania i indeksowania, przez metody replikacji oraz sharding, aż po skomplikowane transakcje rozproszone i algorytmy uzgadniania konsensusu. Autorzy nie skupiają się wyłącznie na opisie narzędzi, lecz także wyjaśniają, dlaczego systemy działają w określony sposób i jakie wyzwania wiążą się z wyborami architektonicznymi. Osobne rozdziały dedykowane są tematom takim jak przetwarzanie wsadowe i strumieniowe, filozofia systemów sterowanych zdarzeniami oraz zagadnienia etyczne związane z pracą na danych osobowych.
Wybierz stan zużycia:
WIĘCEJ O SKALI
W dzisiejszych czasach, gdy chmura obliczeniowa, mikroserwisy i ogromne ilości danych odgrywają kluczową rolę, każda nowoczesna aplikacja musi sprostać wyzwaniom związanym z jej skalowalnością, niezawodnością i wydajnością. Drugie wydanie kultowej książki autorstwa Martina Kleppmanna, uzupełnione o wkład Chrisa Riccominiego, stanowi szczegółowy przewodnik po architekturze systemów danych. Opisuje on zarówno relacyjne bazy danych, jak i rozproszone systemy NoSQL, a także chmurowe hurtownie danych i technologie przetwarzania strumieniowego. W aktualizacji książki uwzględniono najnowsze trendy, takie jak natywna architektura chmurowa, indeksy wektorowe w kontekście sztucznej inteligencji, jak również silniki synchronizacji i oprogramowanie local-first. Publikacja ta przeprowadza czytelników przez cały złożony ekosystem systemów danych, zaczynając od modeli przechowywania i indeksowania, przez metody replikacji oraz sharding, aż po skomplikowane transakcje rozproszone i algorytmy uzgadniania konsensusu. Autorzy nie skupiają się wyłącznie na opisie narzędzi, lecz także wyjaśniają, dlaczego systemy działają w określony sposób i jakie wyzwania wiążą się z wyborami architektonicznymi. Osobne rozdziały dedykowane są tematom takim jak przetwarzanie wsadowe i strumieniowe, filozofia systemów sterowanych zdarzeniami oraz zagadnienia etyczne związane z pracą na danych osobowych.
Szczegóły
Dane producenta:
Inne książki tych autorów

Podobne produkty
Może Ci się spodobać
Inne książki z tej samej kategorii

Napisz opinię o książce i wygraj nagrodę!
W każdym miesiącu wybieramy najlepsze opinie i nagradzamy recenzentów.
Dowiedz się więcejWartość nagród w tym miesiącu
880 zł
Dodaj swoją opinię
Zaloguj się na swoje konto, aby mieć możliwość dodawania opinii.
Czy chcesz zostawić tylko ocenę?
Dodanie samej oceny o książce nie jest brane pod uwagę podczas losowania nagród. By mieć szansę na otrzymanie nagrody musisz napisać opinię o książce.
Już oceniłeś/zrecenzowałeś te książkę w przeszłości.
Możliwe jest dodanie tylko jednej recenzji do każdej z książek.
Sposoby dostawy
Odbiór w punkcie (7)
InPost Paczkomat 24/7

14,99 zł
DPD Pickup Automaty i Punkty Odbioru

11,99 zł

Dostawa na adres (7)
GLS U Ciebie - Kurier
14,99 zł
Kurier DPD

14,99 zł




Sposoby płatności
Płatność z góry
Przedpłata

Zwykły przelew
